GPT-6.1 Terra 骨折价上线,电脑操作反超 Astra,价格只要 1/10
OpenAI 的「中杯」,这次还真有点东西。
先看一段 OpenAI 的官方演示。
用户发过去一张里斯本老城的街景照,画面里停着一辆黄色老式电车,交代的任务只有一句:照着这辆车,做一个够精细的 3D 模型,拿去生产合金玩具车。
接下来,模型自己打开了 3D 建模软件,车身、车窗、底盘,一个部件接一个部件往上拼,最后交出一辆完整的电车模型。视频角落标着:按真实速度播放,只省略了部分片段。
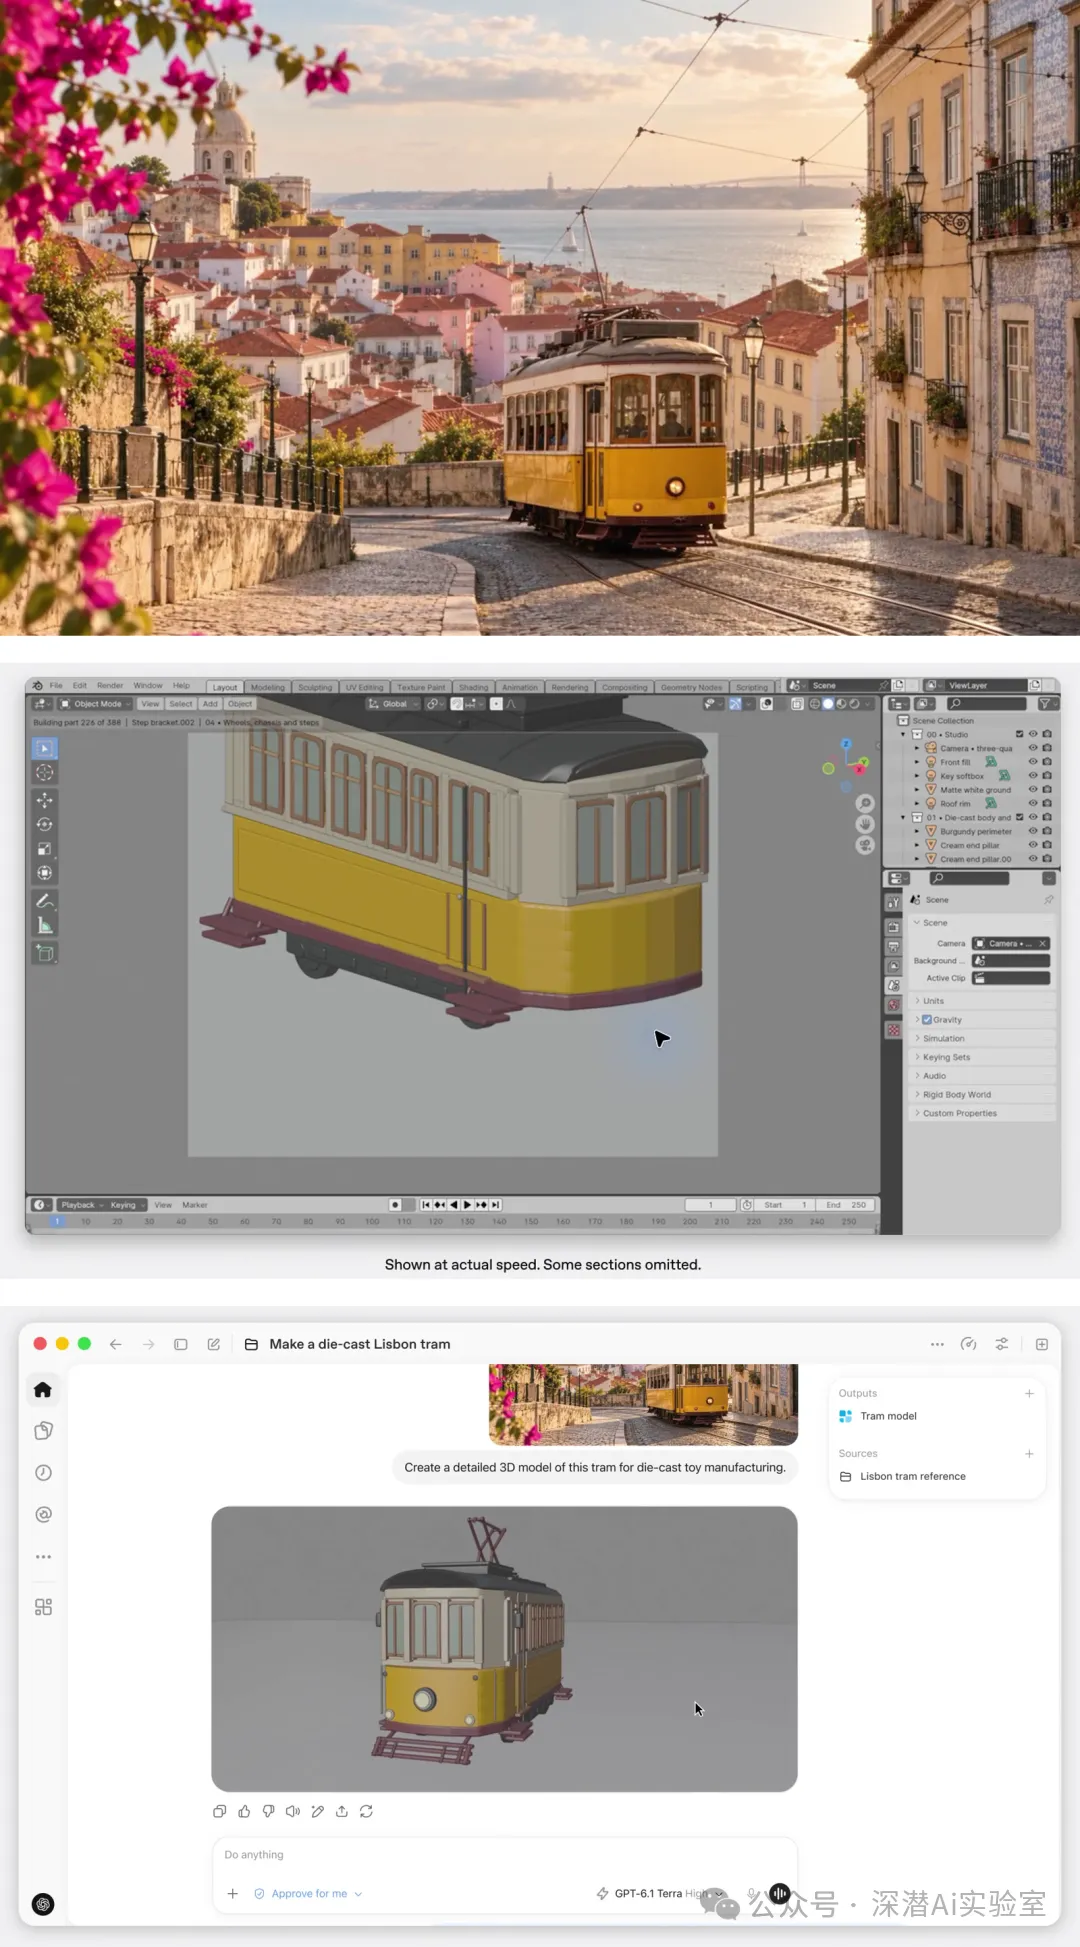
干这活的,是 OpenAI 10 月 27 日凌晨发布的新模型 GPT-6.1 Terra。
它是 OpenAI 这一代模型里的「中杯」,主打又快又便宜:标准 API 价格比 GPT-6.1 Sol 便宜一半,只有旗舰 GPT-6 Astra 的十分之一。可一到操作电脑的活上,它能和 Astra 打个平手;推理强度开满,还能小幅反超。
这个迟到的中杯,这次还真有点东西。
对会员用户来说,更实在的一点是:同一份 Plus 额度,换 Terra 来跑,能干的活是 Sol 的两倍。
- 操作电脑能打
- 三组实测对比
- 门槛与选型
迟到的「中杯」,终于补上了
这次发布,和 Codex 负责人、重置之神 Tibo 的一个约定有关。
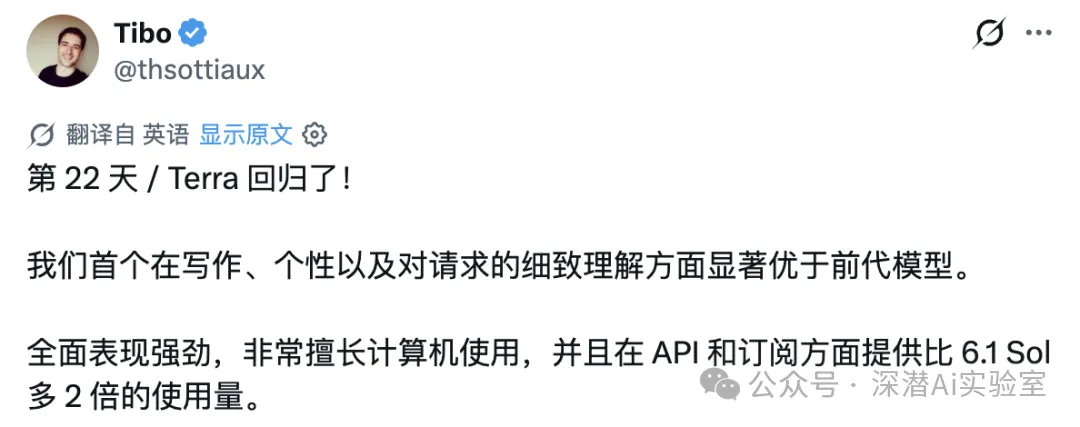
他给自己定了 28 天的期限:每天至少兑现一样,要么上线一个新改进,要么把所有人的额度重置一遍。10 月 27 日轮到第 22 天,大家没等来额度刷新,等来的是一个新模型。
重置之神 Tibo 在发布帖里给它的评价很高:在写作、性格,以及揣摩用户真实意图这几方面,Terra 是他们第一个有明显进步的模型;综合实力很能打,操作电脑尤其拿手。
Sam Altman 也发帖表示,Terra 的改进很多,但他们最兴奋的,是它带来的电脑操作新阶段。
OpenAI 现在按天体给模型起名,个头从大到小排:Astra 是星系,Sol 是太阳,Terra 是地球,Luna 是月亮。
9 月 GPT-6 这一代上线时,Astra、Sol 和 Luna 都先后露了面,偏偏中间那档 Terra 迟迟没来。6.1 版本把它补上,四个尺寸这才凑齐。
四款各有各的分工。OpenAI 给 Terra 的定位很清楚:一款为高频工作准备的高效模型,能力够全面,价格压得够低,好让更多企业和开发者用得起 AI Agent,真正把它接进每天的工作流程。
说白了,它就是 Agent 时代的「打工模型」。
看得懂屏幕,也上得了手
Terra 这次最大的看点,是把「看懂」和「动手」连在了一起。
过去的模型读图、看文档都不成问题,可要它亲手操作电脑,在好几个软件之间切来切去把事办完,对模型能力和推理开销的要求都不低。到了 Terra 这里,能接的活明显多了:看技术图纸、填表格、剪视频,再到操作各种桌面软件,都能上手。
官方举的几个例子都很具体:照着建筑设计图建出 3D 模型;一帧帧检查动画片,给修复团队列出带时间码的镜头清单;公司收到发票,让它把信息读出来,自动填进财务软件。
专业软件实战:和旗舰打平
要衡量这种本事,有个专门的评测叫 Agents’ Last Exam,出的题就是上面这类拿专业软件干的实活。Terra 在这里交出的成绩相当亮眼:
- 57.6% 中档得分(与 Astra 持平)
- 60.0% 满档得分(反超 Astra)
- $0.29 中档单任务(Astra 要 $4.82)
中档推理:得分 57.6%,跟 Astra 完全持平。单个任务花 0.29 美元,同档的 Astra 要 4.82 美元。
最高档推理:得分 60.0%,反超 Astra(59.3%)和 Sol(58.6%),单个任务只要 1.01 美元。
对比上一代:同样开中档,比 GPT-5.6 Terra 高出 15 个百分点,单个任务的花费只剩原来的三分之一左右。
目前在这项评测里拿最高分的是 Claude Opus 5.5(63.2%),不过它跑一个任务得花 8.82 美元,大约是满档 Terra 的 9 倍。OpenAI 还算了另一笔账:同样开到最高推理强度,Terra 用 Token 的效率是 Opus 5.5 的 3 倍多,Token 单价只有它的四分之一,做同一类任务,总成本低了大约 9 倍。
速度:快出 3 倍
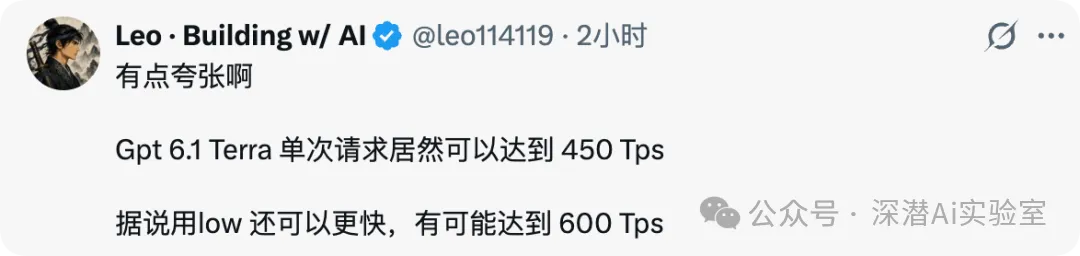
速度同样是它的强项。官方数据显示,完成同样的任务,Terra 比 Astra 和 Sol 快 3 倍以上。有开发者晒出实测:单次请求每秒能吐出 450 个 Token;还有说法称把推理强度调低,能冲到每秒 600 个,不过这个数字还没被证实。
桌面操作和看图:专门测桌面软件操作的 OSWorld 2.1 上,Terra 只开中档推理,成绩就盖过了上一代 Terra 开满档的水平,每次任务的花销还低了一大截。
看图推理的 MMMU-Pro 测试里,它在每一档推理强度上都赢了上一代,成绩逼近 Astra 和 Sol,花的钱却少得多。
第三方榜单:性价比卡在最优线上
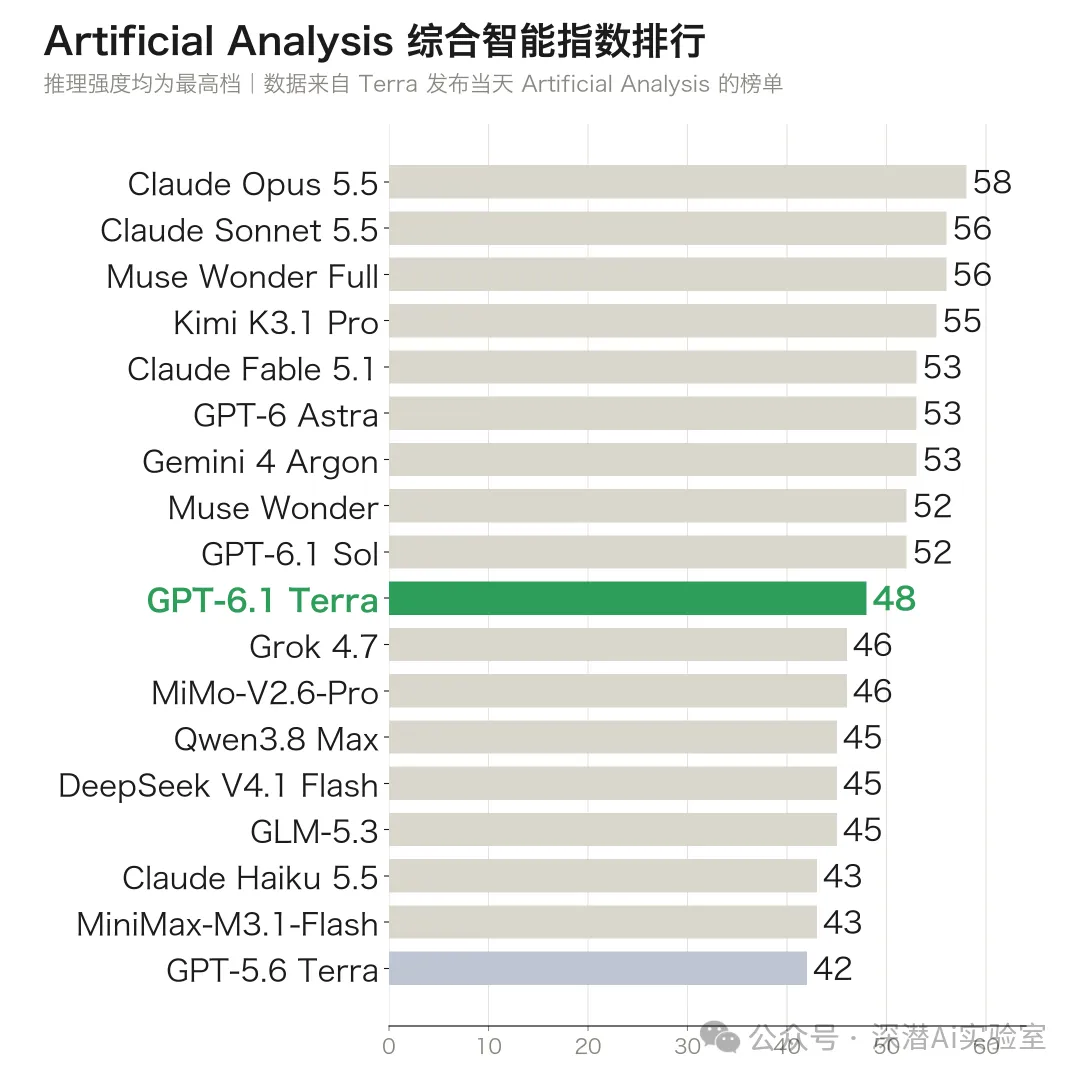
第三方机构 Artificial Analysis 的综合智能榜上,Terra 拿了 48 分,比 Sol 少 4 分;放到中国的开放权重模型里,只有 Kimi K3.1 Pro(55 分)比它高。
要是按性价比来看,Terra 开低档和中档时,正好卡在「花多少钱、拿多少分」的最优边界上:预算一样,没有哪个模型的分数能超过它。
三组实测:又快又省是真的
跑分之外,也有人拿真活做了对比。
案例 1 · 贝伦塔:做得更细,反倒更便宜
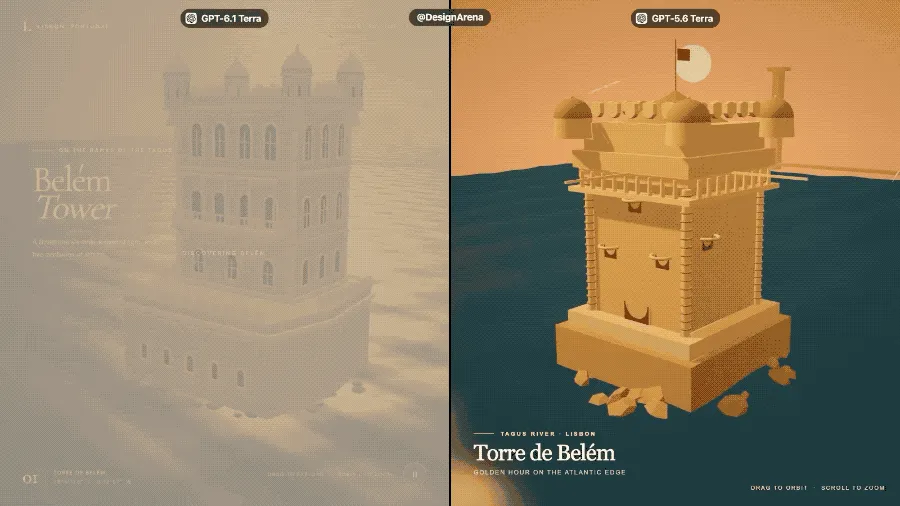
DesignArena 让新旧两代 Terra 还原夕阳下的里斯本贝伦塔。6.1 版本做出的建筑细节和水面光影明显更细腻;它花的时间差不多是上一代的 4 倍,Token 也多烧了 48%,可单次成本反倒从 0.077 美元降到了 0.047 美元。
案例 2 · 8 个 Agent 做游戏:6 分钟收工
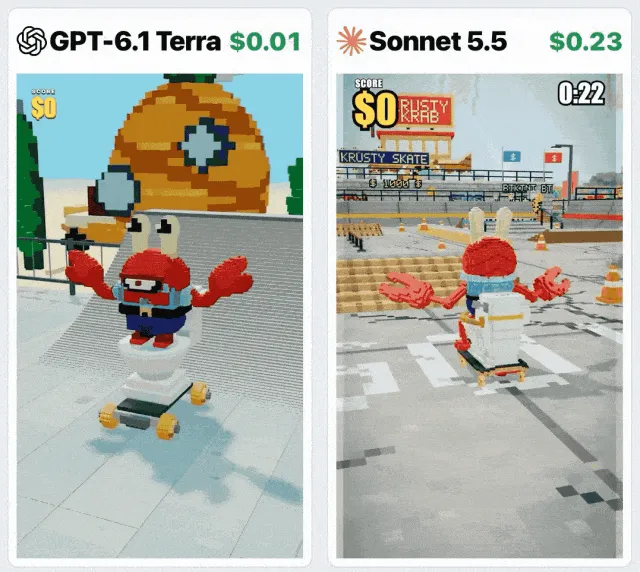
atomic.chat 给两个模型同一段提示词,各派 8 个 Agent 去开发一款游戏。Terra 6 分钟就收了工,花费 1.06 美元;Claude Sonnet 5.5 用了将近一小时、18.10 美元。论成品,Sonnet 做出来的游戏确实更精致,但花的钱是 Terra 的十几倍。
案例 3 · 照片做 3D 电车:Terra 先交卷
还有博主顺着官方演示,在 Codex 里把同一张电车照片分别发给 Terra 和 Sol,让它们借助 Three.js 这个网页 3D 库,各做一个能在浏览器里转着看的电车模型。
Terra 40 秒就交了卷,结果第一次打开是一片白屏;把报错贴回去,它又花 14 秒修好了。Sol 用了 3 分半,一次跑通,还额外附上了铁轨、一张配色卡,外加 4 个预设视角。
那位博主的结论很实在:
「一分钟交出一个能看的初稿,Terra 够用了;想要更精细,还得是 Sol。」
放到难度最高的任务上,从现有的测试看,Claude Opus 5.5 交出的最终成品目前还是更胜一筹。不过 Terra 胜在便宜、出活快,自有它的用武之地。毕竟,现实中有大量工作只需要 AI 把事情做完,并不值得每次都请出最贵的旗舰模型。
更少胡编,代码能力翻倍
电脑操作之外,Terra 在「说得准」和「写得对」这两件事上也有明显进步。
- 16.7% 事实错误率(上一代 53.6%)
- 38% 幻觉率(上一代 88%)
- 50.3% 命令行编程(上一代 21.5%)
事实错误:少了一大截
OpenAI 说,今年一直把模型胡编、事实出错当成重点问题来治。在他们自己设计的一套高难度事实测试里,上一代 Terra 开低档推理,回答里出错的比例高达 53.6%;新 Terra 压到了 16.7%,少了 36.9 个百分点。推理强度开到最高,错误率更是只剩 4.3%,和 Astra、Sol 基本在一个水平。
另一个值得留意的指标是幻觉率,也就是模型明明不知道答案,却硬着头皮瞎猜的比例。上一代 Terra 是 88%,新版只有 38%,Claude Opus 5.5、Astra 和 Sol 的幻觉率都比它高。
对 Agent 来说,这一点格外要紧。要经手合同、技术文档、公司内部数据的时候,能把任务做完只是起点,整个过程能不能一直不出错,才决定了人敢不敢把更多工作放手交给它。
写代码:成绩翻倍
编程方面的进步更大。专门考命令行编程的 Terminal-Bench 4.0 上,Terra 开最高档推理,解决了 50.3% 的任务;上一代 Terra 公开的成绩只有 21.5%,一下子翻了一倍还多。
偏科研方向的 Terminal-Bench-Science 0.1 里,题目包括写代码分析延时摄影中的细胞分裂这类研究任务,Terra 甚至赢过了定位比它高的 6.1 Sol。按 OpenAI 的说法,它和 Claude Opus 5.5 的差距不到 5 个百分点,按估算花的钱还不到对方的五分之一。
当然,OpenAI 自己也把话说在前头:真正复杂的软件工程、深度研究类任务,还是交给 6.1 Sol 和 GPT-6 Astra 更合适。
门槛:谁能用、去哪用、怎么选
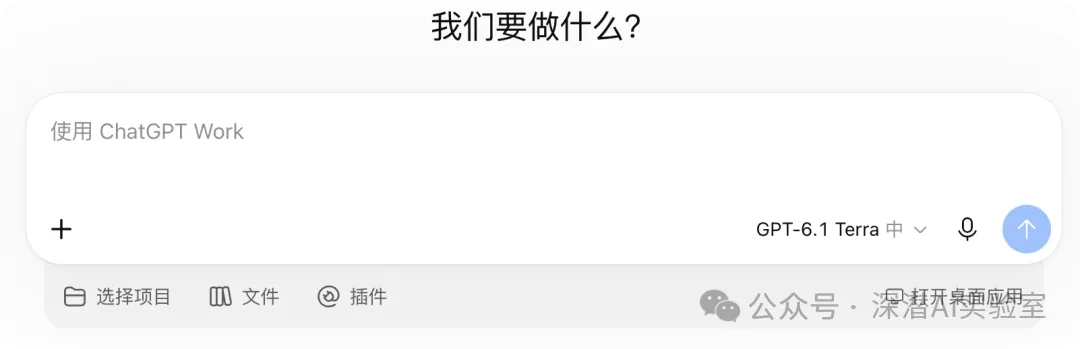
💡 划重点:Terra 不在 ChatGPT 的普通聊天模式里,只能在 ChatGPT Work 和 Codex 里用。
这两个入口已经开始推送。免费版和 Go 用户暂时用不了,其余付费用户,包括 Plus、Pro、企业版和教育版都能用:进到 Work 或 Codex 里,在模型下拉菜单中选 GPT-6.1 Terra 就行。在命令行里跑 Codex 的,先把它升级到最新版,再在启动命令后面加上 -m gpt-6.1-terra。
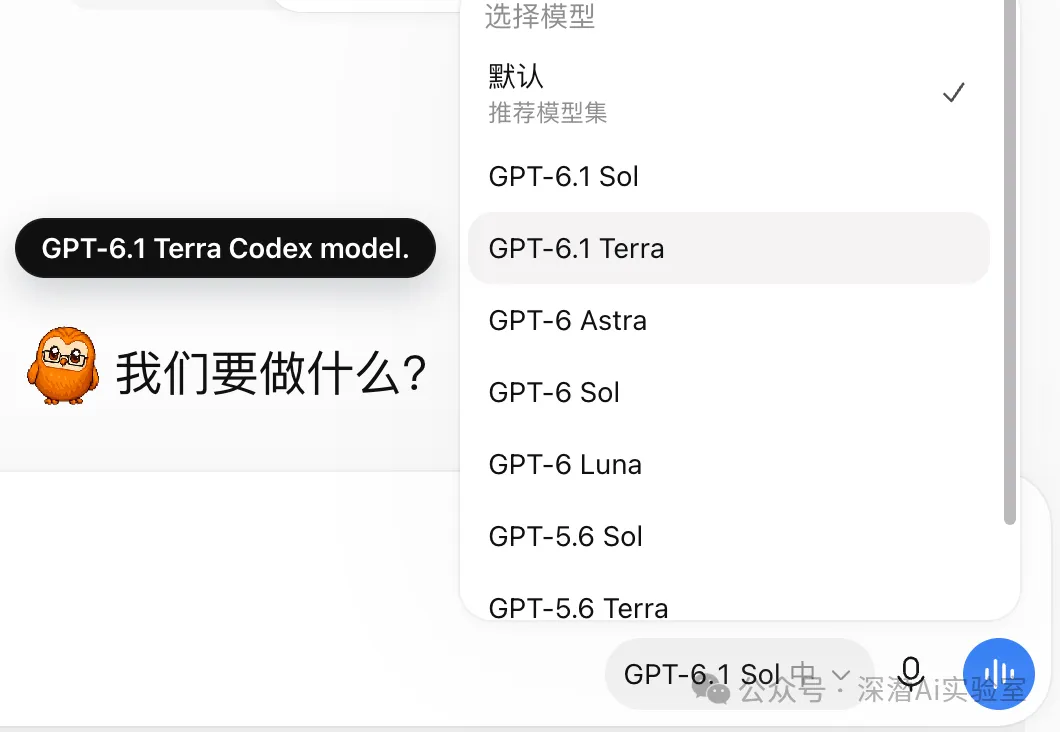
额度是大家最关心的。官方的说法是:同样的额度,用 Terra 能完成的任务比上一代 Terra 多;要是跟 Sol、Astra 比,省额度的效果就更明显了。按重置之神 Tibo 的说法,订阅里 Terra 的可用量是 6.1 Sol 的两倍,Plus 用户换成它,等于同一份额度能多干一倍的活。
四款模型各接什么活,OpenAI 给了官方建议,和 API 价格一起整理在下面:
| 模型 | 适合交给它的活 | API 输入 / 输出 |
|---|---|---|
| GPT-6 Astra | 难度最高、要从头跟到尾的大任务 | $10 / $50 |
| GPT-6.1 Sol | 要反复跑、跑得久,还得控制成本的任务 | $2 / $10 |
| GPT-6.1 Terra | 日常写作、看图和看屏幕、照着原始文件填表 | $1 / $5 缓存输入 $0.05 |
| GPT-6 Luna | 标准明确、数量又大的提取和分类 | $0.10 / $0.50 |
注:API 价格单位为美元,按每百万 Token 计。
开发者也可以直接调用 API,模型名是 gpt-6.1-terra。它的标准价比 GPT-5.6 Terra 和 6.1 Sol 便宜一半,输入、输出单价都只有 Astra 的十分之一。
写在最后
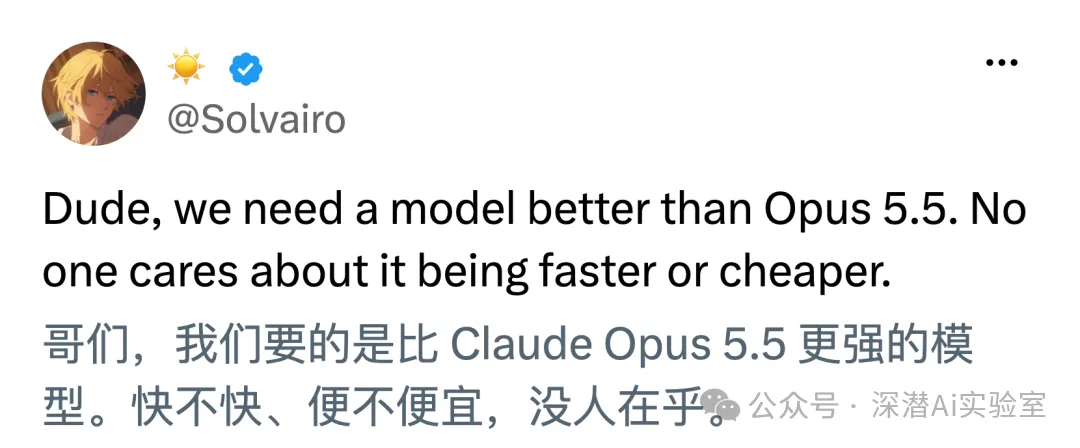
官宣帖底下,讨论最热闹的反倒不是 Terra 本身。有网友直接表示不买账:他们想要的是一个比 Claude Opus 5.5 更强的模型,快和便宜根本无所谓。重置之神 Tibo 的帖子下面,也有人一直追问:GPT-6.1 Astra 去哪了?
这款原本排在 10 月发布的旗舰升级版,在安全测试里被发现比上一代更爱说谎,OpenAI 只好先把它压了下来。
安全这件事,Terra 本身也没放松:它直接沿用了 GPT-6 Astra 那一套防护措施;对齐方面也吃到了 GPT-6 系列的改进,更守用户授权的边界,会主动讲清自己能力的局限,也更扛得住恶意提示词注入。
回头看 OpenAI 今年这一路:Astra 冲最强,Sol 管综合,Terra 主攻高效执行,几款模型之间的分工越分越清楚。
Agent 正在加快走进真实的工作场景,模型之间比的也不再只是谁的跑分高,而是同一件活要花多少钱、耗多少时间,能不能稳定可靠地一直做对。
以前,企业想让 AI 批量处理办公任务,总得在能力、速度、成本之间来回取舍。Terra 让这种取舍没那么疼了:一个看得懂屏幕、会操作软件、能读复杂文档的模型,能力摸到了旗舰的边,Token 成本却只要十分之一,Agent 才真正有条件从少数高价值任务,铺开到大量的日常工作里。
对于 OpenAI 来说,让越来越强的 AI 变得越来越便宜,将与发布下一款最强模型同样重要。
落到我们普通用户身上也是好事:同样一份会员额度,能放心交给 AI 去干的活,越来越多了。
本文首发于微信公众号「深潜Ai实验室」。
支付宝 / 微信付款,客服 5 分钟开通,充值失败可退款。